Определение кодировки текста и перекодирования из одной кодировки в другую.
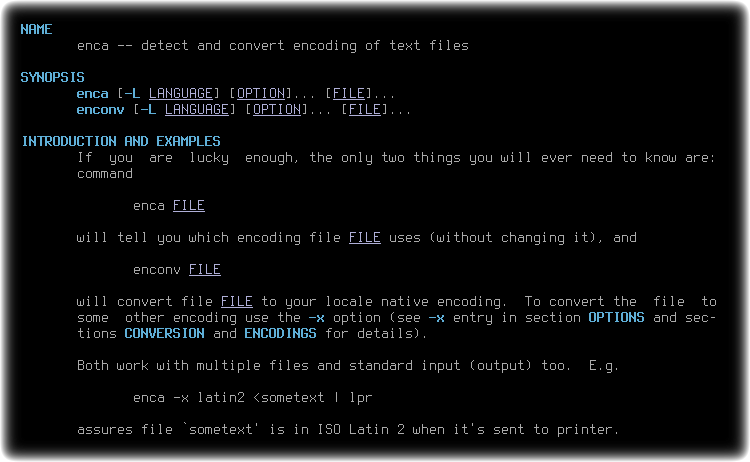
Enca (Extremely Naive Charset Analyser) — набор библиотек и консольные утилиты для анализа кодировки по небольшому отрывку текста и перекодирования текста из одной кодировки в другую.
При работе с различными текстовыми документами, особенно старыми, могут попасться документы при открытии отображающие текст "кракозябрами", это означает что файл имеет кодировку отличную от используемой в системе (обычно это UTF-8). Для того чтобы определить используемую и произвести смену кодировки на системную можно воспользоваться утилитой Enca/enconv.
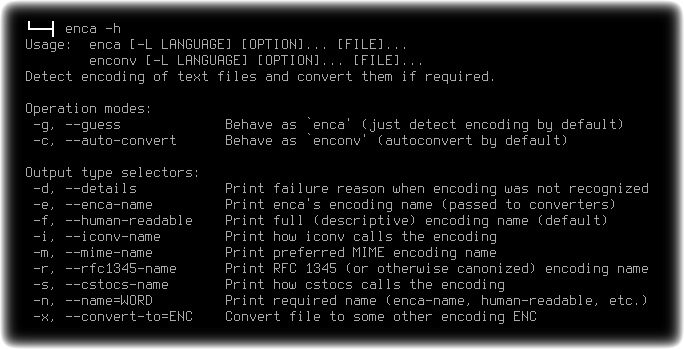
Enca и входящая в её состав утилита enconv сделают смену кодировки быстро и просто. Определить в какой кодировке файл можно выполнив:
enca имя-файла.txt
Для автоматического определения кодировки файла и преобразования её в соответствии с системной кодировкой нужно выполнить:
enconv имя-файла.txt
При необходимости преобразовать файл в кодировку отличную от текущей (системной), например в CP1251, используется команда:
enconv -x CP1251 имя-файла.txt
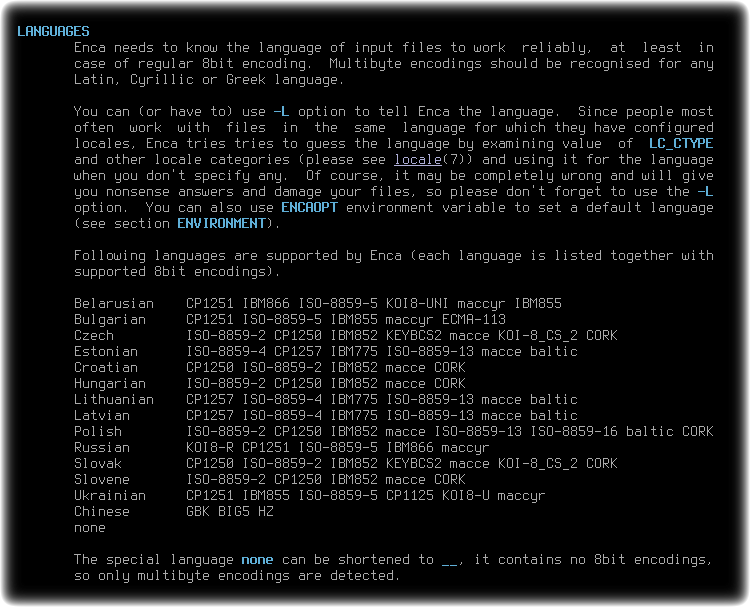
Enca гибкий инструмент, используя дополнительные опции есть возможность изменения кодировки не только отдельных файлов, но и каталога файлов (в том числе рекурсивное), поддерживается преобразование между большинством существующих локалей и кодировок (наиболее распространённых).

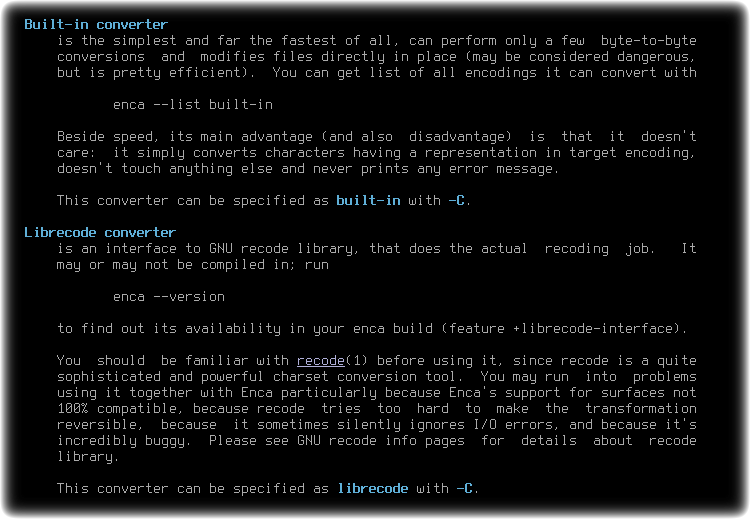
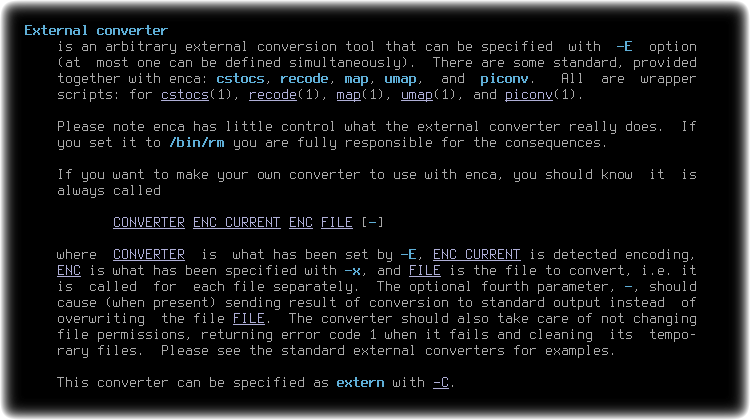
При необходимости Enca может использовать внешние библиотеки и инструменты, такие как libiconv, librecode и cstocs (если не хватает функционала или поддержки экзотических локалей и кодировок у enconv).
Лицензия: GNU General Public License version 2.0 (GPLv2)
Домашняя страница
Страница на github.com
Комментарии (0)
Пока нет комментариев. Будьте первым!