
Приложения для анализа и распознавания текста.
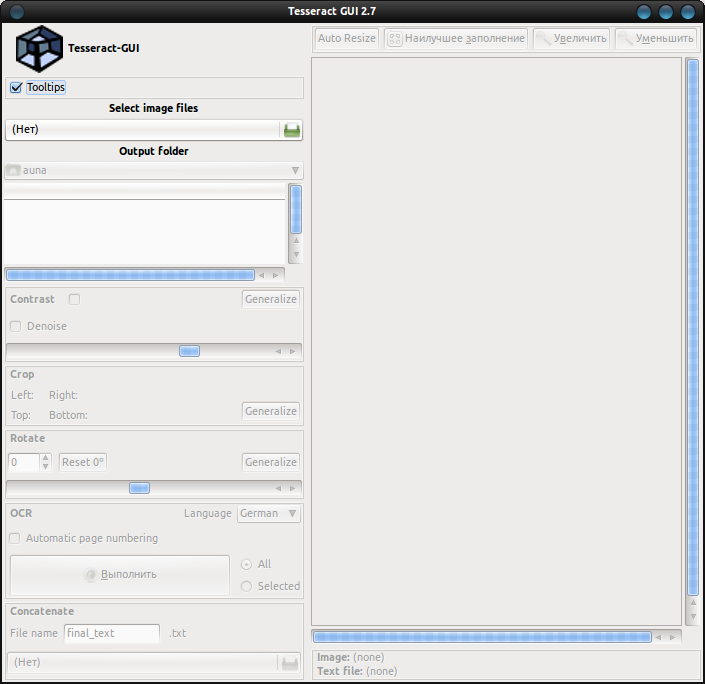
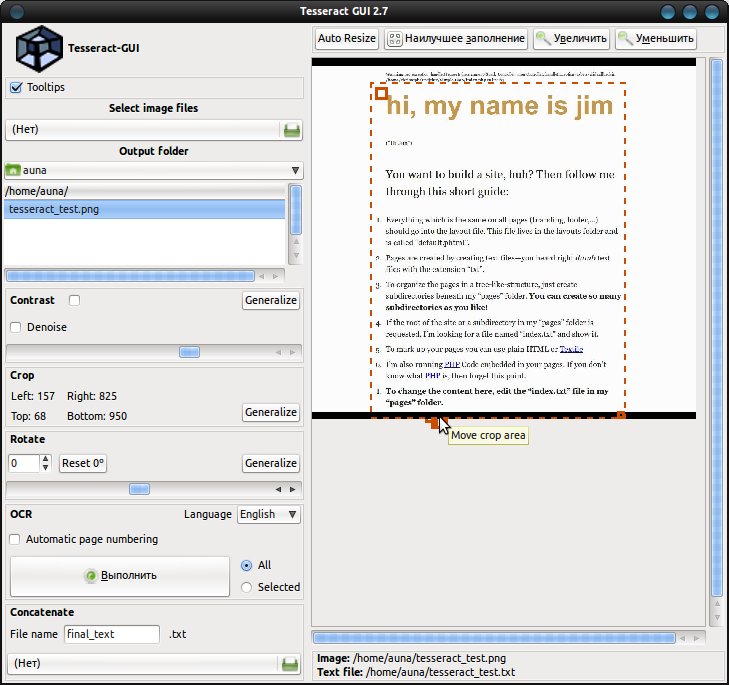
Tesseract-GUI — простой Python / GTK+ графический интерфейс к консольному приложению для распознавания текста Tesseract.
Tesseract — консольное приложение для оптического распознавания текста, признанная одной из трёх лучших приложений по итогам тестирования на точность в 1995 году. Разработкой приложения, с 1985 по 1995 год, занималась компания Hewlett-Packard (HP). После 2005 года разработка Tesseract была заморожена на 10 лет. Но в 2005 году исходные коды приложения были открыты и дальнейшую разработку возглавила компания Google.
Tesseract поддерживает распознавание нескольких языков (включая русский, с версии 3.0) осуществляемое с помощью добавления соответствующих модулей, имеется поддержка UTF-8 (кодировка реализующая представление Юникода).
Открываемые в Tesseract-GUI для распознавания изображения могут быть монохромными (черно-белыми), серыми и цветными. Изображения могут быть форматов PNG или JPG, но для более качественного распознавания текста рекомендуется преобразовать изображение в формат хранения растровых изображений TIFF (Tagged Image File Format).
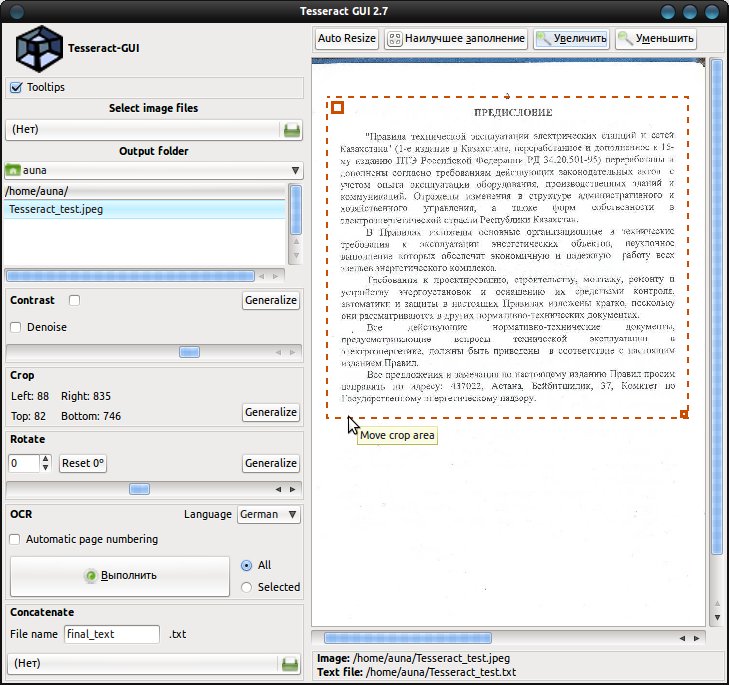
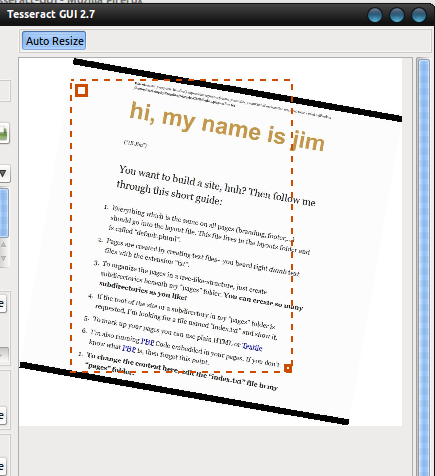
Tesseract-GUI даёт возможность повысить контрастность изображения, изменить угол наклона (на оригинальном изображении изменения не отражаются). Распознаваться может как текст на всём изображении, так и текст выделенного участка изображения.
Для корректной работы (как и tesseract) требует leptonica (библиотека необходимая для приложений анализирующих и работающих с изображениями).
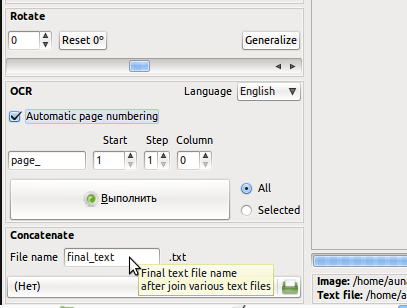
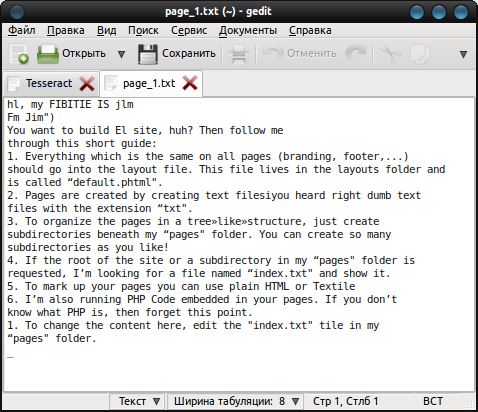
Tesseract-GUI сохраняет распознанный текст в файле формата TXT, в директории с распознаваемым изображением, можно указать свой каталог и дать имя файлу. Если на изображении две страницы (например сканированная книга, два разворота книги) то распознанный текст может быть сохранён как в одном так и нужном числе файлов (постранично).
Лицензия: GNU General Public License (GPL)
Домашняя страница
Страница на sourceforge.net
OCRopus(tm) – система анализа документов и оптического распознавания символов (Optical Character Recognition — OCR) с консольным интерфейсом, для работы использующая Tesseract. Разработчик Thomas Breuel.
Приложение имеет модульную систему распознавания, модульную систему анализа пакета символов в документе, статическое моделирование естественного языка и поддержку нескольких языков (поддерживаемых в Tesseract).
Домашняя страница
Комментарии (0)
Пока нет комментариев. Будьте первым!